Más allá de la herencia: Desentrañando la naturaleza del gen
El gen es la unidad funcional de la herencia. Cada gen es una secuencia dentro del genoma que funciona al dar origen a un producto definido, que puede ser una proteína o un ARN.
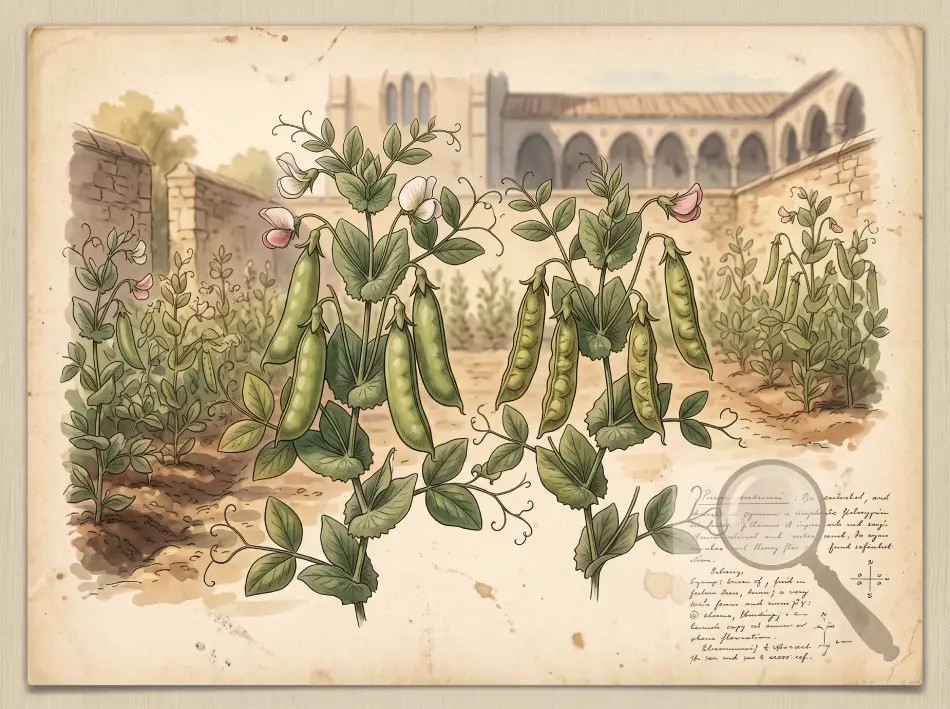
El comportamiento básico de la herencia —la transmisión de caracteres discretos de una generación a otra siguiendo patrones estadísticos predecibles— fue descrito por Gregor Mendel a mediados del siglo XIX.
Un gen puede existir en formas alternativas. Estas formas se denominan alelos.
En los organismos diploides, que poseen dos juegos de cromosomas, una copia de cada cromosoma autosómico se hereda de cada progenitor, y lo mismo ocurre, en general, con los genes que contienen: una copia corresponde al alelo paterno y la otra al materno.
La correspondencia entre el comportamiento hereditario de los genes y el de los cromosomas condujo, a principios del siglo XX, a la formulación de la teoría cromosómica de la herencia (Walter Sutton y Theodor Boveri, 1902–1903): los cromosomas son, en efecto, los portadores físicos de los genes.
Cada cromosoma está constituido por una disposición lineal de genes. Cada gen se encuentra en una ubicación particular del cromosoma, denominada formalmente locus genético. Los alelos de un gen son las diferentes formas que pueden encontrarse en su locus.
Un gen codifica una sola cadena polipeptídica (con matices importantes)
El primer intento sistemático por relacionar los genes con las enzimas —el trabajo de George Beadle y Edward Tatum con Neurospora crassa en la década de 1940— demostró que cada etapa de una ruta metabólica es catalizada por una enzima específica y que puede ser bloqueada por una mutación en un gen diferente. Esto condujo a la hipótesis «un gen: una enzima».
Sin embargo, fue necesario modificar esta hipótesis para incluir proteínas constituidas por más de una subunidad. Si todas las subunidades son iguales, la proteína es un homomultímero y está representada por un solo gen. Si las subunidades son diferentes, la proteína es un heteromultímero, y cada subunidad distinta requiere su propio gen. La hipótesis se reformuló entonces, con mayor precisión, como:
Un gen: una cadena polipeptídica.
Identificar qué proteína corresponde a un gen determinado puede ser una tarea que requiera mucho tiempo. Por ejemplo: la mutación responsable de la variedad de guisante arrugado estudiada por Mendel no fue identificada hasta 1990, cuando Bhattacharyya y colaboradores describieron una inserción de tipo transposón que interrumpe el gen que codifica la enzima ramificadora del almidón I (SBEI).
Es importante recordar que un gen no genera directamente una proteína: un gen codifica un ARN, que a su vez puede traducirse en una proteína. La mayoría de los genes codifican proteínas, pero un número considerable codifica ARN que nunca se traduce (ARN ribosómico, ARN de transferencia, microARN, ARN largos no codificantes, entre otros), y que puede formar parte de la maquinaria de síntesis de proteínas o desempeñar funciones regulatorias.
El principio fundamental, entendido como definición operativa y no como un hecho cerrado, es que Un gen es una secuencia de ADN que especifica la secuencia de un producto funcional (ARN o proteína).
El código genético es de tipo triplete
Cada gen representa una determinada cadena proteica, y cada proteína está constituida por una secuencia específica de aminoácidos.
La secuencia de ADN se transcribe primero en ARN mensajero, y es sobre este ARNm donde se lee el código en grupos de tres nucleótidos: cada codón especifica un aminoácido. Escrita en dirección 5’→3′, la secuencia de la hebra codificante de ADN (idéntica en secuencia al ARNm, salvo el cambio de timina por uracilo) corresponde a la secuencia de aminoácidos de la proteína, leída del extremo N-terminal al C-terminal.
El código se lee en tripletes no superpuestos a partir de un punto de inicio definido. «No superpuesto» significa que cada codón consta de tres nucleótidos y que los codones sucesivos corresponden a trinucleótidos sucesivos, sin compartir posiciones. El punto de inicio definido implica que la traducción avanza en una sola dirección; distintas partes de la secuencia no pueden leerse de forma independiente.
Como el código se lee en tripletes no superpuestos, existen tres marcos de lectura posibles según el nucleótido en que se inicie la lectura. Por ejemplo, para la secuencia ACGACGACGACGACGACG:
Un marco de lectura que consiste exclusivamente en tripletes que pueden representar aminoácidos —sin codones de terminación prematuros— se denomina marco de lectura abierto (ORF, open reading frame). Una secuencia traducible presenta un marco que comienza con un codón de inicio y continúa hasta un codón de terminación.
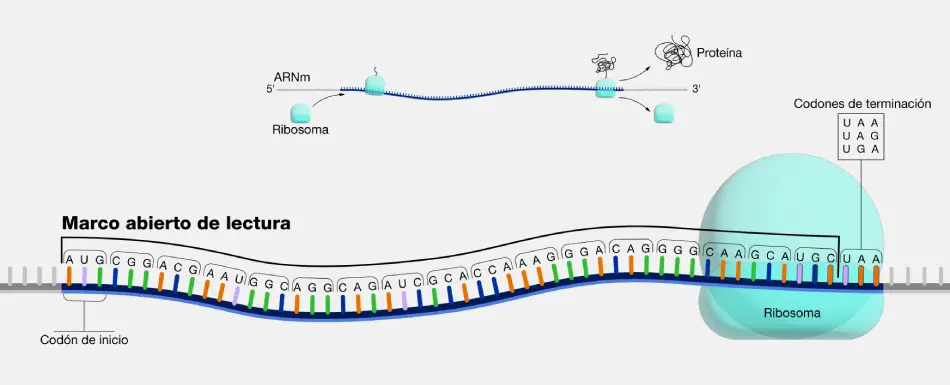
- El codón de inicio más común es AUG (metionina en eucariotas, formilmetionina en bacterias), pero en procariotas GUG e incluso UUG también pueden funcionar como codones de inicio, reconocidos por el contexto de la secuencia de Shine-Dalgarno.
- Los codones de terminación estándar son UAA, UAG y UGA, pero el código genético no es estrictamente universal: en las mitocondrias humanas, UGA no es codón de paro, sino que codifica triptófano.
- En contextos específicos, UGA puede reinterpretarse para incorporar selenocisteína y UAG puede codificar pirrolisina en ciertas arqueas y bacterias.
Si una secuencia contiene codones de terminación prematuros en los tres marcos posibles, no puede codificar una proteína funcional en esa región. Algunos textos clásicos de genética molecular describen esto como un marco de lectura «bloqueado», aunque no es una terminología universalmente estandarizada en la literatura contemporánea.
Cuando se obtiene la secuencia de una región de ADN de función desconocida, se analiza cada uno de los tres posibles marcos de lectura para determinar si está abierto, lo cual puede aportar evidencia de una secuencia codificante. Por lo general, no más de uno de los tres marcos posibles está abierto en un segmento dado de ADN, considerando una sola hebra.
Conclusión
El gen puede definirse, de forma operativa, como la unidad fundamental de la herencia y como una secuencia organizada de ADN capaz de especificar un producto funcional —una cadena polipeptídica o una molécula de ARN no codificante—. Esta definición es el resultado de la convergencia histórica de al menos tres tradiciones distintas: la genética de transmisión mendeliana, la teoría cromosómica de la herencia y la genética bioquímica. Y sigue siendo objeto de refinamiento a medida que la genómica revela fenómenos (splicing alternativo, genes solapados, organización policistrónica) que complican la correspondencia simple entre «un gen» y «un producto». La organización de la información genética mediante un código de tripletes y la existencia de marcos de lectura precisos garantizan, con alta fidelidad, la transmisión y traducción de las instrucciones biológicas necesarias para la estructura y regulación celular.
Referencias
- Bhattacharyya, M. K., Smith, A. M., Ellis, T. H. N., Hedley, C., & Martin, C. (1990). The wrinkled-seed character of pea described by Mendel is caused by a transposon-like insertion in a gene encoding starch-branching enzyme. Cell, 60(1), 115–122. https://doi.org/10.1016/0092-8674(90)90721-P
- Gerstein, M. B., et al. (2007). What is a gene, post-ENCODE? History and updated definition. Genome Research, 17(6), 669–681. https://doi.org/10.1101/gr.6339607
- Portin, P., & Wilkins, A. (2017). The Evolving Definition of the Term “Gene”. Genetics, 205(4), 1353–1364. https://doi.org/10.1534/genetics.116.196956
- Crick, F. H. C., Barnett, L., Brenner, S., & Watts-Tobin, R. J. (1961). General Nature of the Genetic Code for Proteins. Nature, 192(4809), 1227–1232. https://doi.org/10.1038/1921227a0